
Un précédent billet relatait le projet d’attribution d’identifiants DOI aux thèses de doctorat soutenues en France, de manière à la fois rétrospective (dès lors que le dépôt légal a été effectué par voie électronique) et continue. Ce billet précise comment l’Abes a ajouté les identifiants ORCID et ROR dans chaque set de métadonnées Crossref et les conséquences de cet ajout sur l’écosystème global. Il est doublé d’une version adaptée, en anglais, à consulter sur le blog de ROR.
D’où viennent-ils ? Qui sont-ils ? Quels sont leurs réseaux ?
Tiens, des ORCID et des ROR dans les métadonnées Crossref des thèses ?!! Évidemment, parce que ce sont les identifiants acceptés par le modèle en vigueur, admis et reconnus par la communauté internationale. Comment sont-ils arrivés là ? Tout simplement car dans IdRef, qui est le référentiel natif des thèses de doctorat soutenues en France pour les personnes physiques, les collectivités et l’indexation sujet, il existe des correspondances, ou « matching », ou encore alignements, selon notre vocable de prédilection, entre référentiels.
Lectrices et lecteurs assidu-es de ce blog diront : facile, ça nous rappelle ces deux billets précédents où l’Abes et l’université de Strasbourg nous expliquaient par le menu les alignements entre référentiels concernant les organisations et structures de recherche. Pour faire court, la présence d’identifiants ROR dans les notices IdRef s’explique à la fois par l’action continue des réseaux (catalogueuses et catalogueurs de France et de Navarre, chapeau bas !) et quelques opérations-commando de l’Abes.
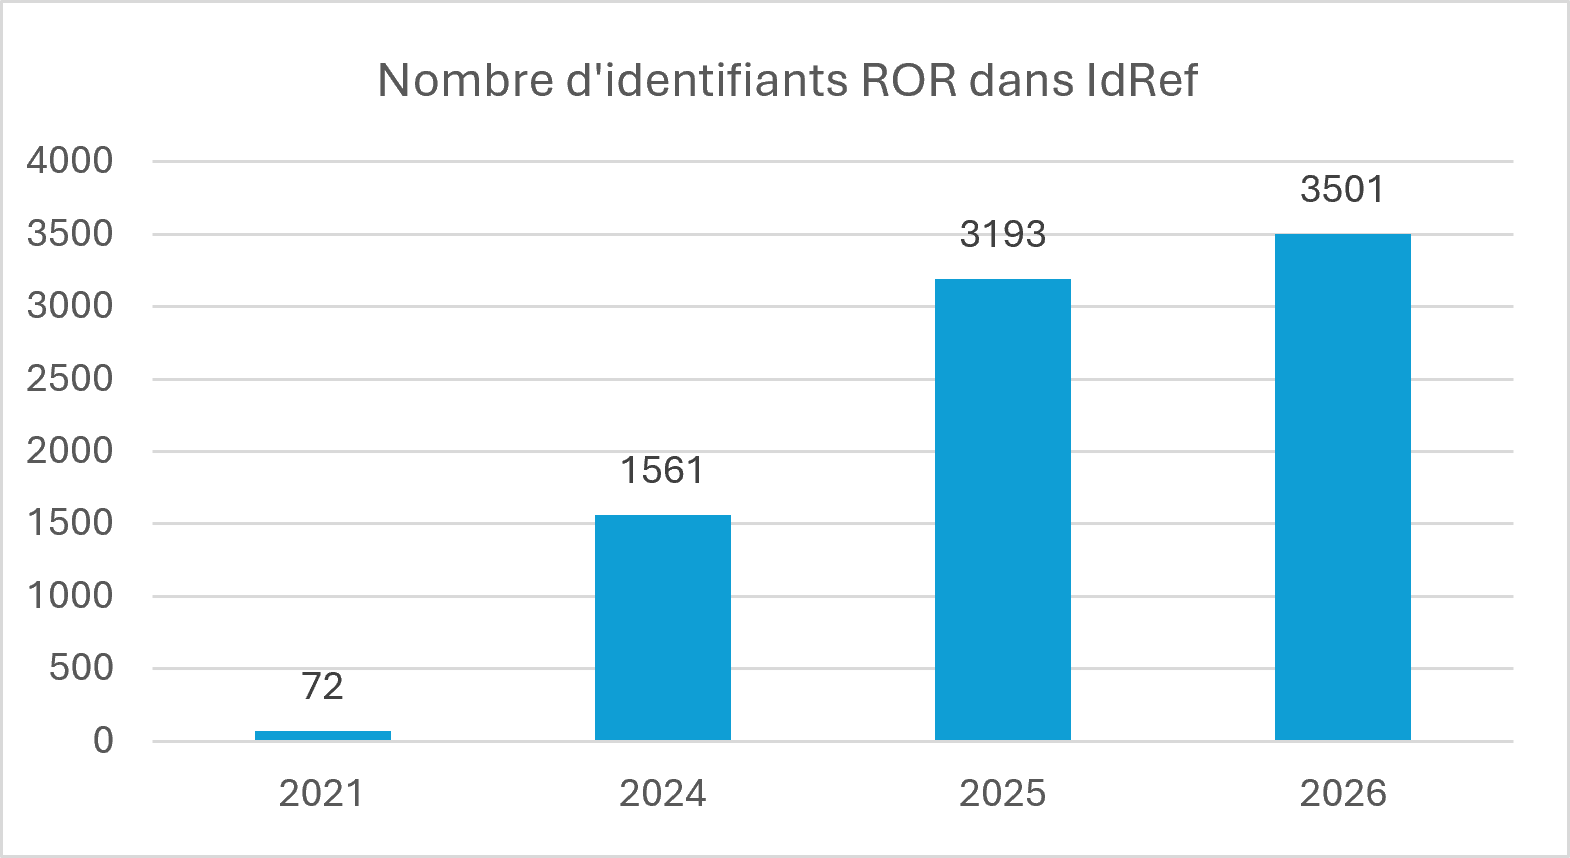
L’évolution de la présence des identifiants ROR dans IdRef montre une progression régulière et substantielle :
Mais concernant ORCID, nous n’avons encore jamais détaillé sur ce blog l’action de l’Abes [1] – qui là encore se combine au travail continu de l’ensemble des personnes du réseau (et même grâce au dehors, via les boutons « signaler une erreur » ou « améliorer la notice » de l’interface IdRef) qui ajoutent, peaufinent, corrigent, maintiennent les identifiants externes dans les notices au fur et à mesure de leur travail quotidien.
ORCID met à disposition chaque année un très gros paquet de données : l’ensemble des informations des comptes pour lesquels les personnes titulaires ont autorisé la diffusion. Toutes les données publiques d’ORCID : ça fait un sacré paquet (comme on peut le voir ici).
L’Abes charge ces données en les modélisant à sa sauce en RDF, poursuivant deux objectifs :
- Identifier dans cette masse les comptes relatifs à la France, à partir de 3 critères qui peuvent se cumuler : la mention explicite du pays ; une adresse mail avec un domaine en .fr ; la mention dans les rubriques « emploi » ou « éducation » d’un établissement français
- Aligner, en s’appuyant sur les métadonnées des publications présentes dans les comptes et notamment les co-autorats, des comptes ORCID avec des notices IdRef.
On travaille à la fois au bulldozer et au bistouri : les propositions d’alignements sont faites en masse par des algorithmes, mais les vérifications et la validation de l’alignement reviennent à l’œil humain, qui a parfois fort à faire pour distinguer des homonymes de domaines scientifiques proches.
Une fois obtenus, ces alignements permettent le tour de passe-passe d’envoyer à Crossref non pas l’IdRef de la personne tel qu’il figure dans le TEF, mais l’ORCID correspondant trouvé dans la notice IdRef, douillettement installé dans sa zone Unimarc A035.
Et que fait-on si on n’a pas d’ORCID dans la notice IdRef ? Rien malheureusement, et c’est bien ce qui est fort dommage. Le schéma de Crossref n’acceptant aucun autre identifiant de personne, il n’y a donc pas d’identifiant du tout – alors qu’outre l’IdRef, on aurait pu imaginer utiliser s’ils sont connus l’ISNI, ou l’ID wikidata par exemple, qui sont des PIDs ouverts et internationaux, et sont admis dans le schéma pour qualifier les organisations[2].
Sur les 190 000 DOI Crossref de thèses forgés à ce jour, 57 000 mentionnent un ORCID – soit presque un tiers. L’identifiant ROR est présent dans plus de 90% des cas, le différentiel devant être comblé rapidement après création des identifiants encore manquants pour les anciennes organisations habilitées à délivrer le doctorat, comme les PRES.
Les routes migratoires des PIDs

Ce qui fait la beauté du geste, c’est que l’histoire ne s’arrête pas là. Les PIDs n’ont pas pour vocation de rester sagement assis dans leur coin, ils s’empressent de se lever pour se promener dans le vaste monde.
Dans les bases bibliographiques, déjà, notamment OpenAlex. Mais l’un des traits de génie d’avoir choisi des DOIs de chez Crossref (et non de chez Datacite, ce qui eut été moins cher et eut permis plus de fantaisie dans les métadonnées, et qui par ailleurs ne serait nullement exotique puisque d’autres pays ont fait ce choix pour leurs thèses [3]), c’est que Crossref est déjà le canal majoritaire par lequel se remplissent (presque) magiquement les profils ORCID.
En effet, l’un des intérêts d’un compte ORCID pour la personne qui le détient est que, comme le balai magique de l’apprenti sorcier, on peut lui déléguer les tâches fastidieuses – au hasard, tenir à jour sa liste de publications. Il suffit d’un clic pour autoriser un tiers de confiance à automatiquement ajouter sur le compte désigné les travaux pour lesquels l’ORCID a été communiqué en amont, dans le processus de publication. Ainsi, le bataillon des thèses françaises rejoignant les rangs des millions de sets de métadonnées Crossref ont pu très tranquillement, sans accroc ni couture (seamlessly !) apparaître dans les comptes ORCID, pourvu que chercheuses et chercheurs en aient auparavant donné la permission.
En cette fin du mois d’août 2026, 33 364 comptes ORCID mentionnent un DOI de thèse française. Pas si mal ! On peut d’ailleurs supposer que le ratio ira en s’améliorant, puisque les thèses qui seront cataloguées désormais ont davantage de chances d’avoir été soutenues par une personne disposant d’un ORCID, la diffusion de l’identifiant allant bon train.
Et pour ROR ? Moment de fierté nationale à voir apparaître un organisme français sur le podium des autorités de nommage fournissant le plus de métadonnées contenant des ROR à Crossref – 170 000 ajouts d’un coup d’un seul, ça en jette !
Vous pouvez retrouver le quart d’heure de célébrité de l’Abes sur le support et la vidéo du ROR Community call du mois de mai 2026.
 Chacun sa route, chacun son chemin, chacun son rêve, chacun son destin
L’imbrication des niveaux international et national prend tout son sens : le DOI ne rend pas caduc le NNT, comme ORCID et ROR n’invalident pas IdRef. Au contraire, le rôle de pivot des référentiels nationaux montre ici son efficacité pour, à peu de frais, enrichir considérablement les métadonnées exposées urbi et orbi et contribuer à rendre visible la recherche française au sein du Research Nexus : « A rich and reusable open network of relationships connecting research organisations, people, things, and actions; a scholarly record that the global community can build on forever, for the benefit of society. »
Carole Melzac, Abes
[1] Mais vous pouvez aller revoir les interventions Journées ABES qui en parlent, comme cette session de 2021ou celle de 2019 – et relire le numéro 112 de la revue Arabesques publié en 2024.
[2] Cf documentation du schéma Crossref 5.5 à l’adresse https://data.crossref.org/reports/help/schema_doc/5.5.0/index.html ; élément « institution_id »
[3] Si l’on interroge l’API Datacite, au 28/08/26, ce sont près de 850 000 sets qui décrivent des documents de type « dissertation » – https://api.datacite.org/dois?resource-type-id=Dissertation